
Wie LLM-gestützte Systeme lernen – und warum Benutzung alleine nichts verbessert
Viele Menschen glauben, dass ein KI-System mit jeder Nutzung automatisch besser wird. „Je öfter wir es verwenden, desto schlauer wird es.“ Das klingt plausibel, ist aber falsch. Ein Large Language Model (LLM) verbessert seine Antworten nicht automatisch durch häufige Nutzung oder Korrekturen in Gesprächen. Ohne strukturierte Datenflüsse, Feedback-Schleifen und gezielte Verbesserungsmechanismen bleibt die Qualität gleich oder nimmt sogar ab.
Auch neue Funktionen wie Memory, autonome Agenten und Kontextfenster mit Millionen Tokens ändern daran nichts. Sie versorgen das Modell mit mehr Informationen, verändern aber nicht automatisch das Modell selbst.
Dieser Beitrag zeigt, wie LLM-Systeme durch reale Nutzung besser werden können, welche Rolle Feedback spielt und wie sich die drei zentralen Verbesserungshebel unterscheiden: Context-Engineering, RAG und Fine-Tuning. Außerdem geht es darum, wie sich diese Prozesse mit einer KI-Middleware wie izz.ONE datenschutzkonform und herstellerunabhängig umsetzen lassen.
Was bedeutet „Lernen“ bei LLM-Systemen?
Bei LLM-Systemen müssen wir drei Ebenen unterscheiden:
- Gewichtslernen: Beim Training oder Fine-Tuning werden die Modellparameter verändert. Nur dadurch lernt das Modell selbst dauerhaft neue Fähigkeiten oder Verhaltensweisen. Produktive Modelle lernen jedoch nicht automatisch aus einzelnen Unterhaltungen.
- Wissenszufuhr zur Laufzeit: Context-Engineering und RAG versorgen das Modell mit zusätzlichen Informationen, Instruktionen und Werkzeugen. Auch Memory-Funktionen gehören dazu: Sie speichern Informationen und stellen sie bei späteren Anfragen erneut bereit. Das Modell selbst bleibt unverändert.
- Systemlernen: Feedback, Regeln, Tool-Aufrufe, Tests und Evaluationen verbessern die Architektur rund um das Modell. Obwohl keine Modellparameter verändert werden, kann die Qualität dadurch kontinuierlich steigen.
Die wichtigste Erkenntnis: Nur Fine-Tuning schreibt neues Wissen in das Modell. Context-Engineering und RAG verbessern die Informationsversorgung. Systemlernen optimiert den gesamten Prozess.
Ohne gutes Feedback kein Fortschritt
Ein System kann nur dann gezielt verbessert werden, wenn Feedback strukturiert erfasst und ausgewertet wird.
Besonders wertvoll ist explizites Feedback:
- Bewertungen wie Daumen hoch oder runter
- Korrekturvorschläge und alternative Antworten
- Labels wie „faktisch falsch“, „veraltet“ oder „unvollständig“
- Der tatsächliche Erfolg einer Aufgabe, beispielsweise die Lösung eines Support-Tickets
Daneben gibt es implizites Feedback. Nutzerabbrüche, wiederholte Fragen, lange Bearbeitungszeiten oder häufige menschliche Eingriffe bei Agenten können auf Probleme hinweisen.
Damit diese Signale aussagekräftig werden, brauchen sie Kontext-Metadaten: Use Case, Abteilung, verwendete Datenquellen, Dokumentversion, Modell- und Prompt-Version sowie Berechtigungen.
Ein Freitext wie „War nicht gut“ hilft wenig. Eine markierte Passage mit dem Label „falsch, Quelle X, Stand Y“ ist dagegen konkret verwertbar.
Datenqualität entscheidet
Schlechte Feedback-Daten verschlechtern das System. Deshalb braucht es klare Label-Definitionen, Stichprobenkontrollen und kuratierte Referenzfälle (Gold-Standards). Bei uneindeutigen Fällen empfiehlt sich eine doppelte Annotation.
Auch LLM-as-a-Judge, bei dem ein zweites Modell Antworten bewertet, kann die Qualitätssicherung beschleunigen. Menschliche Stichproben bleiben jedoch notwendig.
Datenschutz muss von Anfang an berücksichtigt werden: personenbezogene Daten maskieren, Zweckbindung sicherstellen und Löschkonzepte definieren.
Drei Wege zur Verbesserung: Context-Engineering, RAG und Fine-Tuning
1. Context-Engineering: der schnellste Hebel
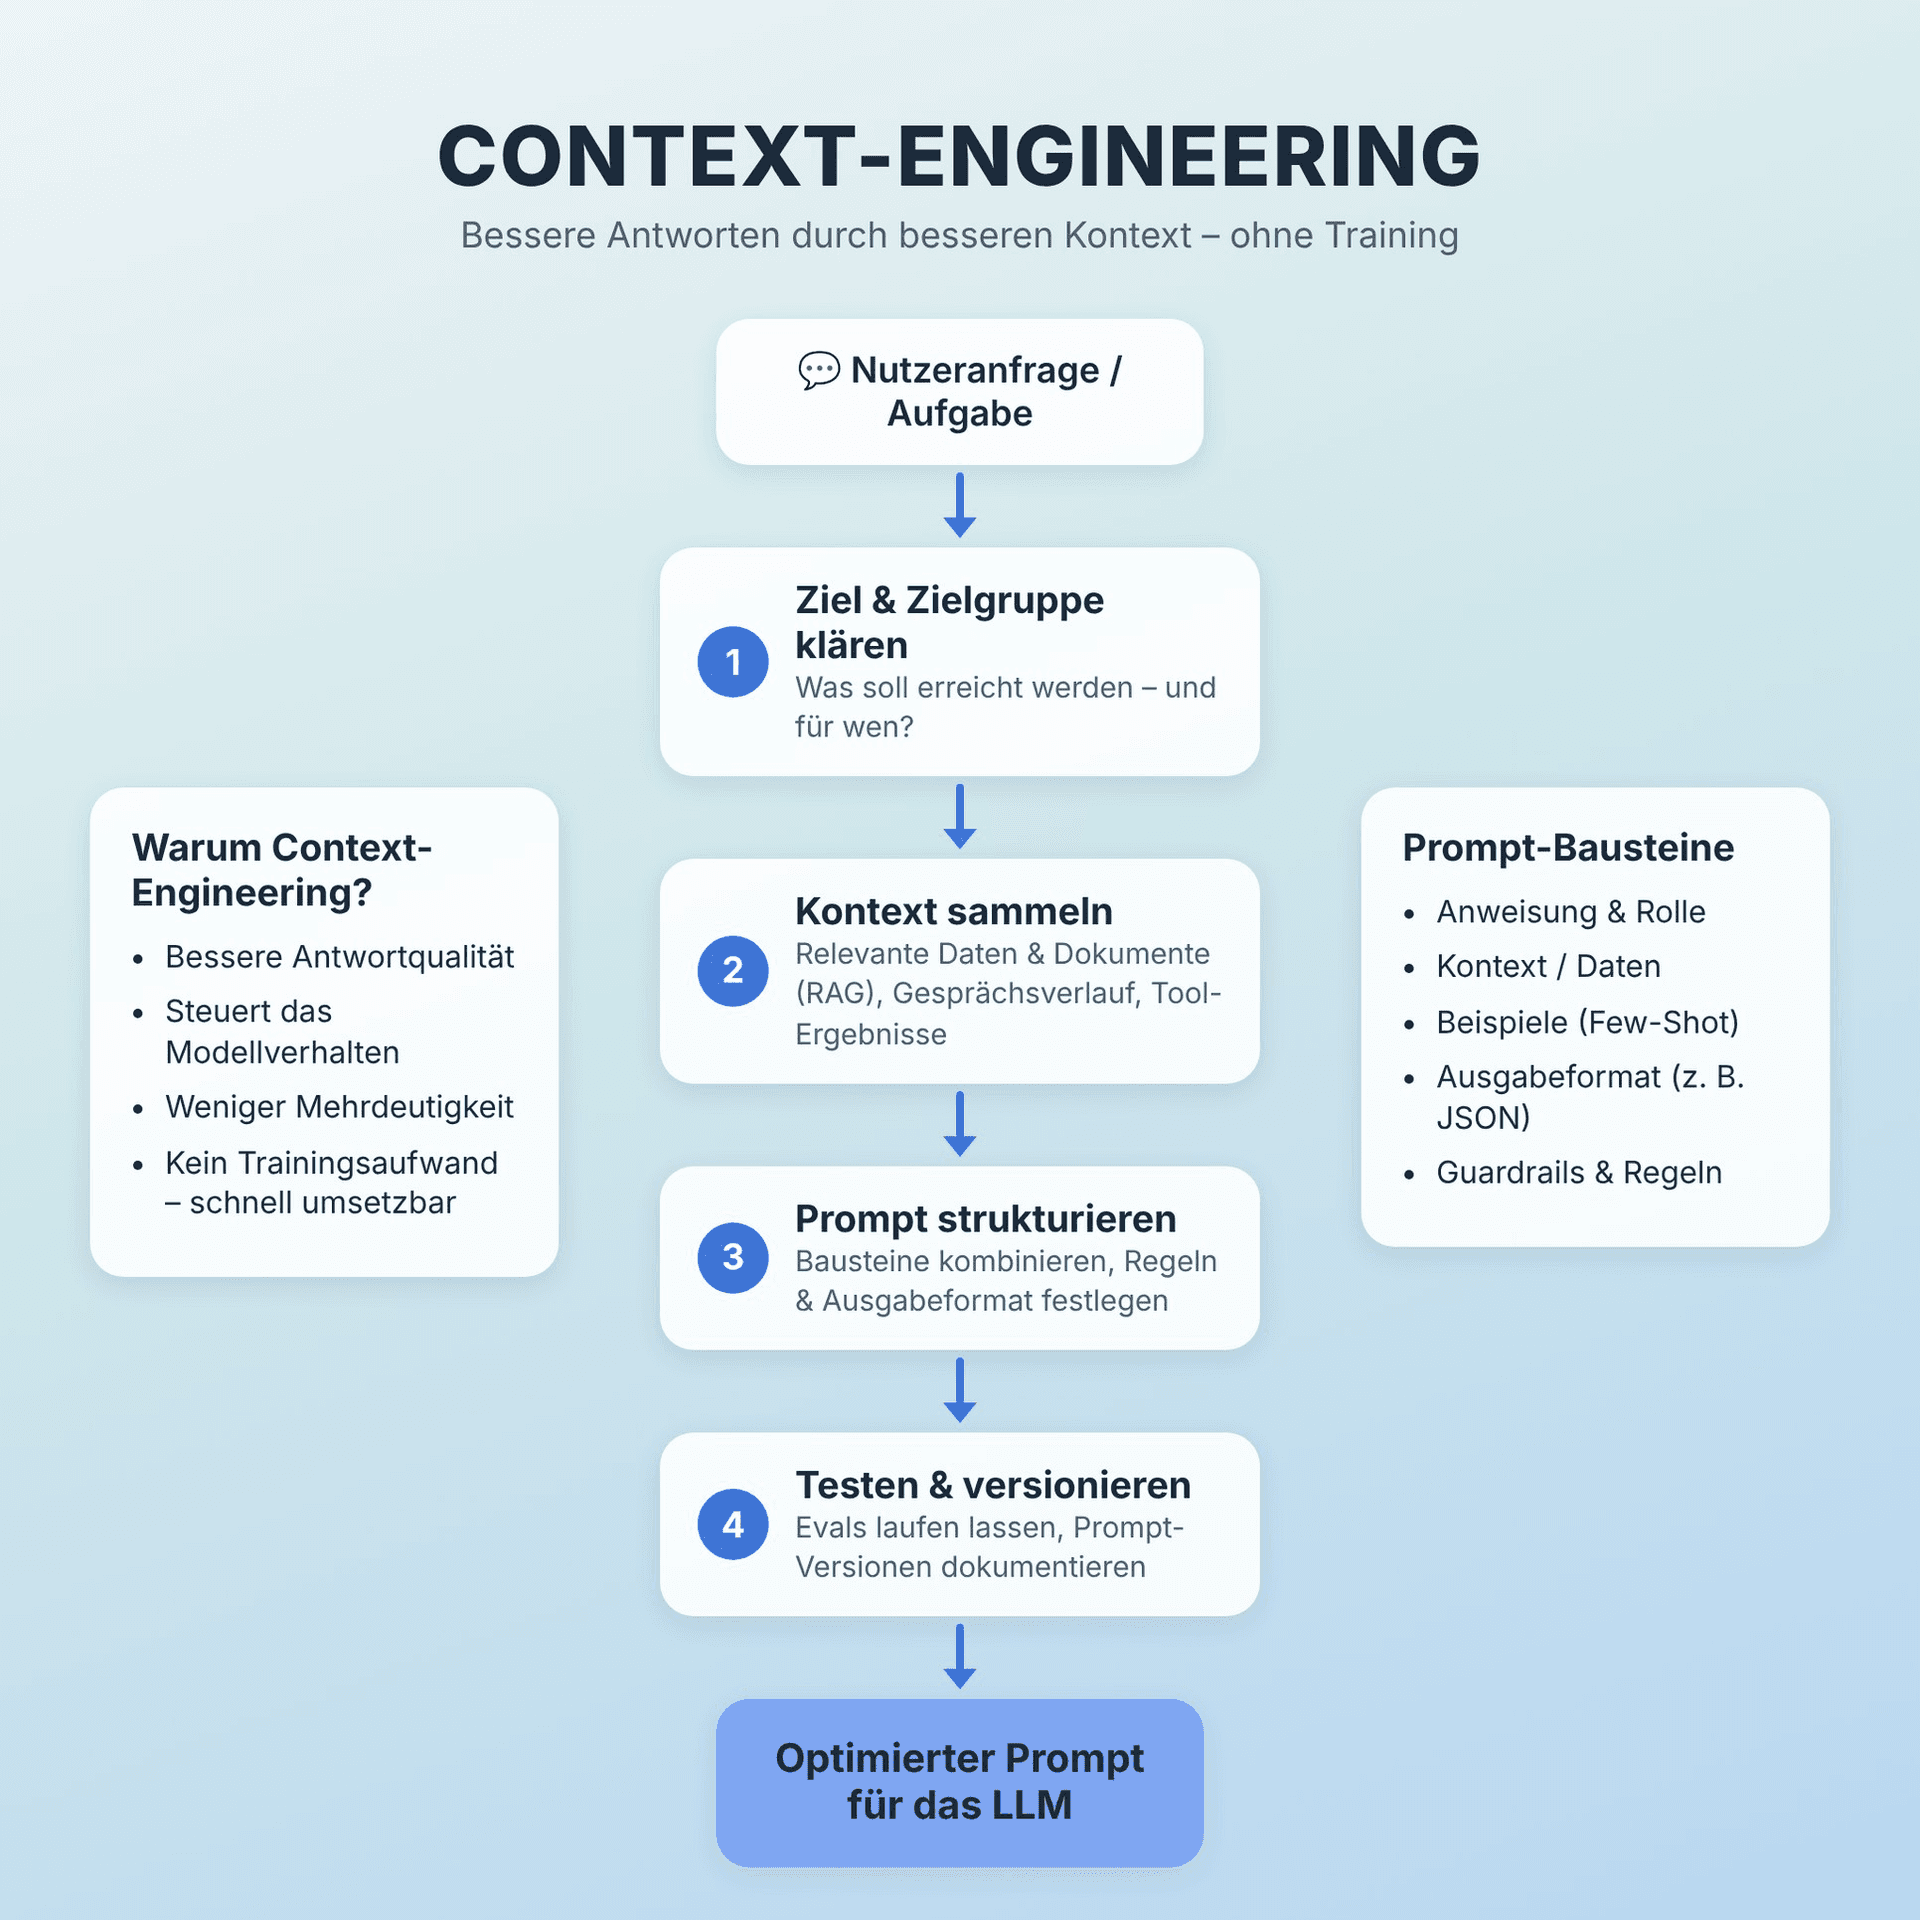
Context-Engineering geht über klassisches Prompt Engineering hinaus. Entscheidend ist nicht nur die Formulierung eines Prompts, sondern welche Informationen, Werkzeuge und Zwischenergebnisse das Modell in jedem Arbeitsschritt erhält.
Dazu gehören:
- System-Instruktionen und Rollen
- Strukturierte Ausgabeformate wie JSON-Schemas
- Tool-Aufrufe für Suche, Berechnungen oder ERP-Abfragen
- Guardrails und Sicherheitsregeln
- Orchestrierung mehrstufiger Agenten-Workflows
Beispielsweise kann ein IT-Assistent Antworten standardisiert nach Diagnose, Lösungsschritten und Quellen ausgeben. Ein Vertriebsassistent verwendet ein Kalkulations-Tool, statt Margen zu schätzen.
Die Grenzen: Context-Engineering erzeugt kein neues Wissen. Die Qualität hängt vom bereitgestellten Kontext und den verfügbaren Tools ab. Außerdem können Modell-Updates die Ergebnisse verändern. Zu viel Kontext erhöht Kosten und Latenz und kann die Antwortqualität sogar verschlechtern.
Bewährt haben sich deshalb versionierte Prompts, strukturierte Ausgabeformate und automatisierte Evaluationen.
Mit izz.ONE: Der grafische Agent Builder orchestriert Prompt-Schritte und Tool-Aufrufe. Durch die Middleware bleibt das System modellagnostisch: Verschiedene LLMs lassen sich testen, ohne die gesamte Logik neu aufzubauen.
2. RAG: Wissen aus eigenen Daten – aktuell und belegbar
Retrieval-Augmented Generation (RAG) ermöglicht es einem LLM, auf unternehmenseigene Informationen zuzugreifen und Antworten mit Quellenangaben zu erstellen.
Ein typisches RAG-System besteht aus mehreren Komponenten:
- Konnektoren binden Dokumente, Wissensdatenbanken, Ticketsysteme und Datenbanken an.
- Inhalte werden in Abschnitte zerlegt (Chunking) und als Embeddings vektorisiert.
- Metadaten wie Autor, Datum und Berechtigungen werden ergänzt.
- Hybride Suche, Re-Ranking und Query-Rewriting identifizieren relevante Informationen.
- Das LLM formuliert daraus eine Antwort mit Quellenangaben.
Beim zunehmend verbreiteten Agentic RAG entscheidet ein Agent selbstständig, wann und wo er Informationen recherchiert.
Die Vorteile liegen in aktuellen Informationen, nachvollziehbaren Quellen und kontrollierbaren Zugriffsrechten. Die größten Risiken sind schlechte Suchergebnisse durch ungeeignetes Chunking, unzureichende Berechtigungskonzepte und veraltete Dokumente.
Bewährt haben sich hybride Suche, Freshness-Signale für aktuelle Dokumente und regelmäßige Messungen mit Retrieval-Metriken wie Recall@k und nDCG sowie Antwortmetriken wie Faithfulness.
Mit izz.ONE: Die Middleware verbindet unterschiedliche Datenquellen herstellerunabhängig mit dem gewünschten LLM. Mandantenspezifische Vektorindizes und Zugriffskontrollen ermöglichen einen sicheren Betrieb. Über MCP-Server lassen sich Suchfunktionen, APIs und weitere Werkzeuge standardisiert integrieren.
3. Fine-Tuning: wenn das Modell wirklich lernen soll
Beim Fine-Tuning werden die Modellparameter verändert. Das eignet sich insbesondere für:
- Unternehmensspezifische Fachsprache und Tonalität
- Spezielle Klassifikations- und Extraktionsaufgaben
- Wiederkehrende Workflows und Verhaltensregeln
Voraussetzung sind hochwertige, repräsentative Trainingsdaten, klare Zieldefinitionen und getrennte Trainings-, Validierungs- und Testdatensätze.
Der größte Aufwand liegt meist in der Datenaufbereitung. Zudem können veraltete Trainingsdaten oder zu enge Anwendungsbereiche die Qualität verschlechtern. Da Basismodelle immer schneller besser werden, sollte Fine-Tuning nur bei einem klar messbaren Mehrwert eingesetzt werden.
Parameter-effiziente Verfahren wie LoRA reduzieren die Kosten. Für bestimmte Aufgaben reichen bereits einige hundert bis wenige tausend kuratierte Beispiele. Reinforcement Fine-Tuning und Präferenzlernen wie DPO bieten zusätzliche Möglichkeiten, insbesondere bei klar bewertbaren Ergebnissen oder konsistenten Stilvorgaben.
Mit izz.ONE: Feedback-Daten lassen sich kuratieren und Fine-Tuning-Pipelines herstellerunabhängig anstoßen. Neue Modellversionen können kontrolliert ausgerollt und bestimmten Use Cases zugeordnet werden.
Wie aus Nutzung echte Verbesserung wird: der Lern-Kreislauf
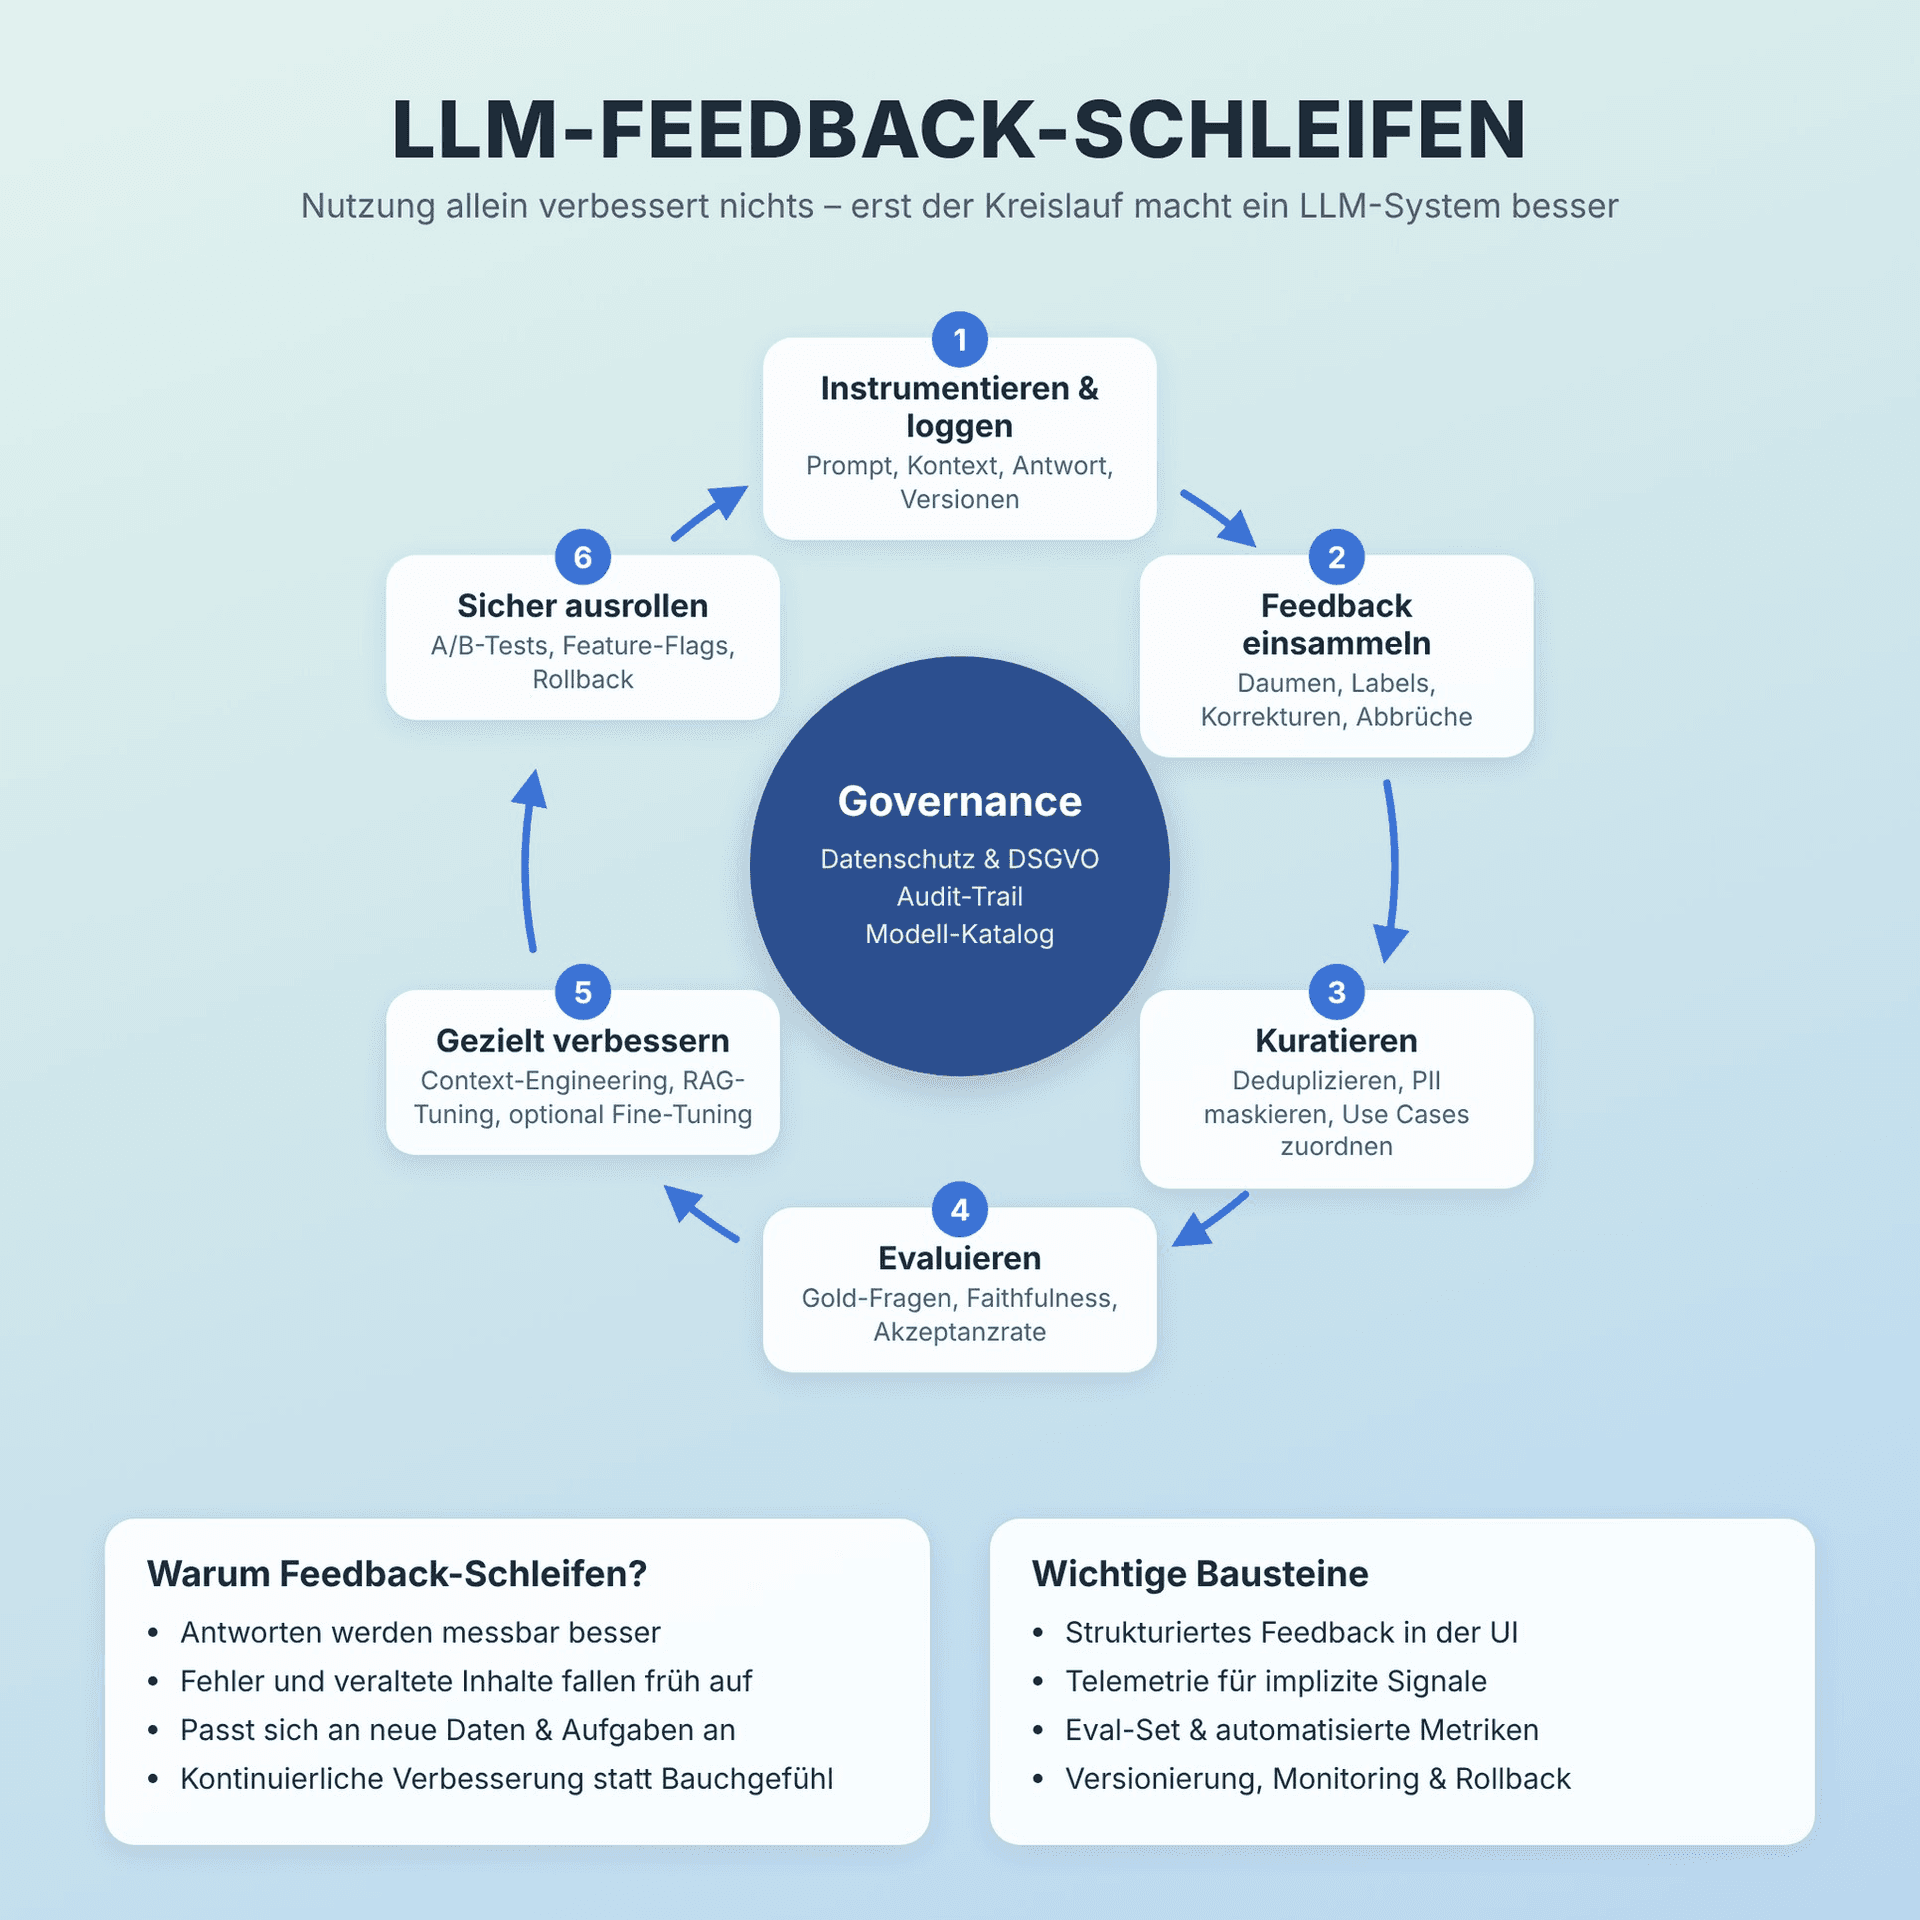
Ein nachhaltiger Verbesserungsprozess umfasst sieben Schritte:
- Logging: Prompts, Kontexte, Antworten, Quellen, Tool-Aufrufe sowie Modell- und Prompt-Versionen dokumentieren.
- Feedback: Explizite Bewertungen und implizite Nutzersignale erfassen.
- Kuratierung: Dubletten entfernen, personenbezogene Daten maskieren und Feedback nach Use Cases kategorisieren.
- Evaluation: Antworten anhand von Gold-Standards auf Genauigkeit, Quellenqualität, Akzeptanz und Policy-Verstöße prüfen.
- Optimierung: Prompts, Retrieval-Parameter, Datenquellen und gegebenenfalls Trainingsdaten verbessern.
- Rollout: Änderungen mit A/B-Tests, Shadow-Traffic und Rollback-Option kontrolliert einführen.
- Governance: Datenschutz, Berechtigungen, Audit-Trails und Modellversionen nachvollziehbar dokumentieren.
Wichtig ist, dass jede Änderung messbar bleibt. Nur so lässt sich feststellen, ob eine neue Prompt-Version oder RAG-Konfiguration tatsächlich bessere Ergebnisse liefert.
Mit izz.ONE: Feedback-Erfassung, Logging, Evaluation, RAG-Aktualisierung und Fine-Tuning lassen sich in einem durchgängigen Prozess verbinden. MCP standardisiert die Tool-Anbindungen, der Agent Builder orchestriert die Abläufe.
Praxisbeispiel: vom Chatbot zum produktiven IT-Assistenten
Ein Unternehmen möchte einen IT-Support-Assistenten einführen. Ziel sind eine Erstlösungsquote von über 70 Prozent, Quellenangaben und DSGVO-konformer Zugriff auf freigegebene Dokumente.
Wochen 1–2: Context-Engineering
Das Team definiert klare System-Instruktionen, Ausgabeformate und Guardrails. Antworten enthalten Diagnose, Lösungsschritte und Quellen. Über eine Tool-Anbindung kann der Assistent Ticketinformationen abrufen.
Wochen 3–6: RAG
Wissensartikel, Change-Logs und Runbooks werden angebunden und indexiert. Hybride Suche bevorzugt aktuelle Dokumente. Rollenbasierte Berechtigungen verhindern den Zugriff auf vertrauliche Inhalte.
Ein Eval-Set aus 200 anonymisierten Tickets ermöglicht die Messung von Retrieval-Qualität, Antworttreue und Lösungszeit.
Parallel: Feedback und Evaluation
Nutzer können Antworten bewerten und als falsch, veraltet oder unvollständig markieren. Ein wöchentliches Dashboard vergleicht Prompt- und Retrieval-Versionen. Ein LLM-as-a-Judge unterstützt die Bewertung, ergänzt durch menschliche Stichproben.
Optional: Fine-Tuning
Aus echten Supportfällen entstehen rund 1.000 kuratierte Frage-Antwort-Paare. Ziel sind bessere Fehlerdiagnosen, ein konsistenter Stil und nachvollziehbare Schritt-für-Schritt-Anleitungen.
Nach drei Monaten steigt die Erstlösungsquote beispielsweise von 74 auf 82 Prozent. 96 Prozent der Antworten enthalten Quellen, die Bearbeitungszeit sinkt um 28 Prozent.
Die entscheidende Erkenntnis: Nicht die Anzahl der Anfragen verbessert das System, sondern die systematische Auswertung und Umsetzung des Feedbacks.
Häufige Irrtümer und Anti-Patterns
Einige Fehler begegnen Unternehmen besonders häufig:
- „Wir sammeln erstmal alles an Feedback.“ Ohne klare Labels und Qualitätskontrollen entstehen unbrauchbare Daten.
- „Bei Fehlern machen wir direkt Fine-Tuning.“ Oft reichen aktuellere Dokumente, besseres Chunking oder optimierte Prompts.
- „Ein globaler Vektorindex reicht.“ Ohne Mandantentrennung und Zugriffskontrollen entstehen erhebliche Compliance-Risiken.
- „Halluzinationen sind immer ein Modellproblem.“ Häufig fehlen passende Quellen oder Werkzeuge. Erst RAG und Guardrails optimieren.
- „Memory bedeutet, dass die KI lernt.“ Persönliche Memory-Funktionen ersetzen keine geprüfte Unternehmenswissensbasis.
- „Wir messen später.“ Ohne Baseline lässt sich keine Verbesserung nachweisen.
Entscheidungshilfe: Welcher Hebel ist der richtige?
Die Wahl hängt vom eigentlichen Problem ab:
- Aktualität, Quellen und Compliance: RAG.
- Struktur, Formate und Tool-Nutzung: Context-Engineering.
- Spezielle Fähigkeiten, Fachsprache und konsistenter Stil: Fine-Tuning.
In der Praxis ist die Kombination entscheidend: Context-Engineering steuert den Ablauf, RAG liefert die Fakten und Fine-Tuning verbessert bei Bedarf spezifische Fähigkeiten.
Die wichtigsten Erfolgsmetriken
Ein gutes Dashboard sollte mindestens folgende Kennzahlen enthalten:
- Aufgabenerfolg: Wurde das gewünschte Ergebnis erreicht?
- Faithfulness: Sind die Antworten durch Quellen gedeckt?
- Quellenabdeckung: Wie viele Antworten enthalten valide Belege?
- Retrieval-Qualität: Recall@k, nDCG und MRR.
- Nutzerakzeptanz: Wie häufig werden Antworten positiv bewertet?
- Lösungszeit: Wie lange dauert es bis zum erfolgreichen Abschluss?
- Policy-Verstöße: Wie häufig greifen Sicherheitsmechanismen ein?
- Kosten pro Vorgang: Tokens, Tool-Aufrufe und Indexpflege.
Ein wichtiger Tipp: Automatisiere deine Evals und führe sie regelmäßig aus, insbesondere nach Modell-Updates. Nur was kontinuierlich gemessen wird, lässt sich planbar verbessern.
Datenschutz und Compliance von Anfang an
Nachhaltiges Lernen setzt einen vertrauenswürdigen Betrieb voraus. Dazu gehören Datenminimierung, Maskierung personenbezogener Informationen, klare Rechtsgrundlagen und Löschfristen.
Zugriffsrechte müssen vom Dokument bis zum Retrieval durchgängig greifen. Änderungen an Modellen, Prompts und Datenbeständen müssen über Audit-Trails nachvollziehbar sein.
Auch der EU AI Act erhöht die Anforderungen an Dokumentation, Protokollierung, menschliche Aufsicht und Evaluation. Unternehmen sollten diese Grundlagen frühzeitig schaffen, insbesondere bei Hochrisiko-Anwendungen.
Mit izz.ONE: Mandantentrennung, Zugriffskontrollen, Protokollierung und konfigurierbare Speicherorte in der eigenen Infrastruktur unterstützen einen datenschutzkonformen Betrieb.
Konkreter Umsetzungsplan für 90 Tage
Zeitraum
Maßnahmen
Wochen 1–2
Use Cases priorisieren, Erfolgskriterien definieren, Eval-Set und Datenschutzkonzept erstellen
Wochen 3–4
Context-Engineering, Guardrails und Tool-Anbindungen umsetzen
Wochen 5–8
Datenquellen anbinden, RAG implementieren und Retrieval optimieren
Wochen 9–12
Feedback-Prozesse etablieren und optional Fine-Tuning vorbereiten
Ab Woche 13
Wöchentliche Evals, Datenpflege und regelmäßige Governance-Reviews
Änderungen sollten grundsätzlich kontrolliert über A/B-Tests und Feature-Flags ausgerollt werden. Ein Rollback muss jederzeit möglich sein.
Fazit
Benutzung allein macht ein LLM-System nicht besser. Auch Memory-Funktionen, große Kontextfenster und leistungsfähige Agenten ändern daran nichts.
Echte Verbesserung entsteht durch strukturierte Feedback-Schleifen, verlässliche Evaluationen und die gezielte Kombination dreier Hebel:
- Context-Engineering für Struktur, Instruktionen und Tools.
- RAG für aktuelle, belegbare Antworten aus eigenen Daten.
- Fine-Tuning für dauerhafte Fähigkeiten und spezifische Verhaltensweisen.
Der entscheidende Faktor bleibt die Datenqualität: Shit in, shit out.
Mit einer Middleware wie izz.ONE lassen sich diese Prozesse herstellerunabhängig und datenschutzkonform verbinden – von der Datenintegration über MCP und den Agent Builder bis hin zu Feedback, Evaluation und optionalem Fine-Tuning.
So entsteht kein System, das allein durch Nutzung besser wird, sondern eines, das durch gezielte und messbare Verbesserungsprozesse kontinuierlich dazulernt.